La comprensión se juega fuera del ejemplo.
Melanie Mitchell estudia inteligencia artificial desde una pregunta persistente: qué permite reconocer una estructura en una situación y llevarla hacia otra diferente. Desde Copycat y los algoritmos genéticos hasta los grandes modelos de lenguaje, su trabajo persigue abstracción, analogía, sentido común y generalización. El punto decisivo aparece cuando la máquina enfrenta algo verdaderamente nuevo. Ahí se vuelve visible cuánto aprendió de la estructura y cuánto dependía de los ejemplos que ya conocía.
Fuentes principales: Douglas Hofstadter y Melanie Mitchell, trabajos sobre Copycat y analogía; Melanie Mitchell, Complexity: A Guided Tour (2009); Artificial Intelligence: A Guide for Thinking Humans (2019); “Why AI is Harder Than We Think” (2021); Moskvichev, Odouard y Mitchell, “The ConceptARC Benchmark” (2023); Mitchell, Palmarini y Moskvichev, trabajos sobre GPT-4 y razonamiento abstracto (2023); Santa Fe Institute, programas sobre Foundations of Intelligence, AI and the Barrier of Meaning y composicionalidad (2021–2026).
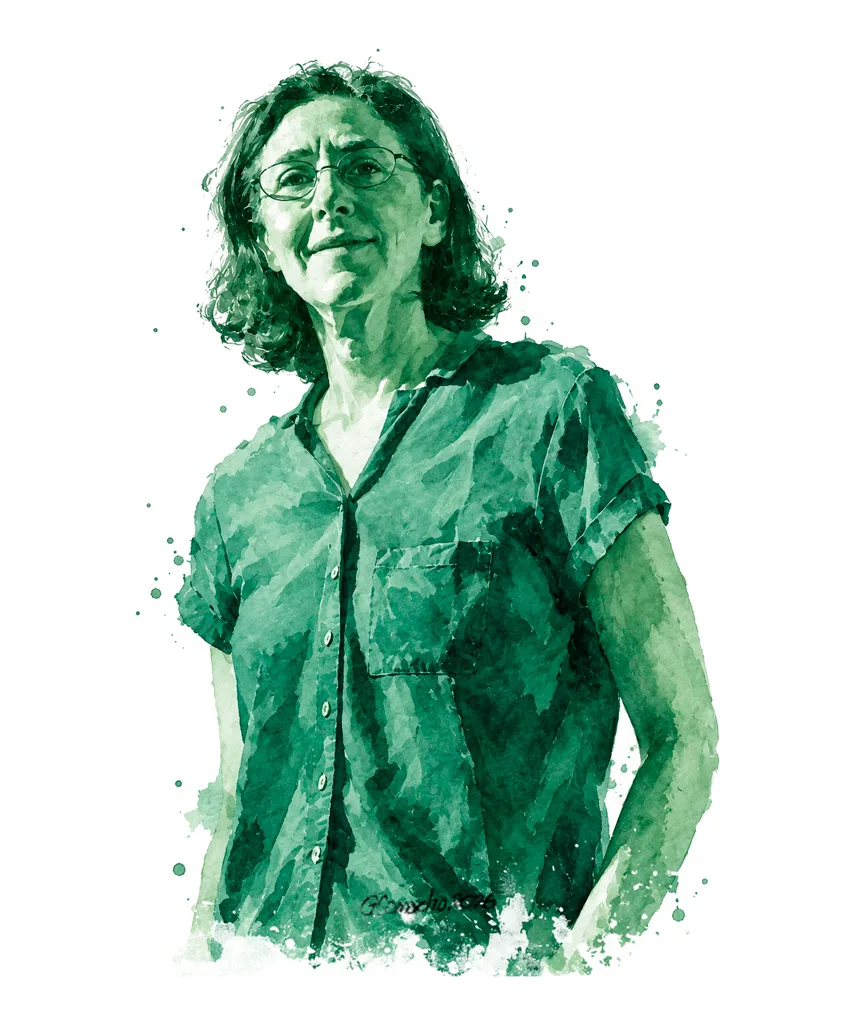
«Esta noción de qué es, exactamente, la inteligencia resulta extremadamente problemática.»
— Melanie Mitchell.
Durante un tiempo, Melanie Mitchell enseñó matemática en una escuela secundaria de Nueva York. Viajaba en subte y leía Gödel, Escher, Bach, el libro de Douglas Hofstadter que reunía lógica, música, autorreferencia y preguntas sobre cómo puede surgir una mente de procesos que, tomados por separado, no parecen pensar. La lectura tuvo una consecuencia poco habitual: Mitchell quiso trabajar con el autor y terminó haciéndolo.
En los años ochenta participó en el desarrollo de Copycat, un programa que intentaba resolver analogías construidas con letras. El mundo de prueba era pequeño a propósito. Si ABC se convierte en ABD, ¿qué transformación habría que aplicar a IJK? Una persona puede responder IJL casi sin esfuerzo, porque interpreta que la operación consiste en sustituir la última letra por su sucesora. Sin embargo, llegar a esa respuesta exige descubrir qué relación importa, distinguirla de los detalles accidentales y trasladarla a una situación nueva. Lo que cabe en tres letras puede exigir una teoría nada pequeña de la inteligencia.
Esa pregunta atravesó el trabajo posterior de Mitchell en algoritmos genéticos, sistemas complejos, ciencia cognitiva, visión computacional y aprendizaje automático. Escribió Complexity: A Guided Tour y Artificial Intelligence: A Guide for Thinking Humans, impulsó cursos abiertos sobre complejidad y continuó investigando en el Santa Fe Institute. A su alrededor cambiaron las arquitecturas, el tamaño de los modelos y las promesas asociadas con ellos. Ella siguió volviendo a la capacidad de abstraer, establecer analogías y generalizar.
Hay una buena razón para esa persistencia. Resolver correctamente un problema conocido puede demostrar una habilidad extraordinaria sin decirnos todavía cómo se comportará esa habilidad cuando desaparezcan las pistas familiares. Mitchell propone observar justamente ese desplazamiento. Me parece un punto de partida más incómodo, y también más fértil, que decidir de antemano si una máquina entiende o simplemente imita.
PENSAR MEDIANTE RELACIONES
En Copycat, las letras eran una especie de laboratorio de bolsillo. Una transformación como ABC → ABD admite varias descripciones. Podemos decir que se reemplazó la C por una D o que el último elemento de una serie fue sustituido por su sucesor. Ambas sirven para explicar el ejemplo inicial, pero no son igualmente útiles cuando la tarea cambia. La segunda conserva una relación que puede aplicarse en otro contexto.
A Hofstadter y Mitchell les interesaba ese momento en que una interpretación particular se convierte en una estructura transportable. Copycat debía ensayar correspondencias y construir representaciones que no estaban fijadas por completo desde el comienzo. Su arquitectura articulaba múltiples procesos locales: unos proponían agrupamientos, otros sugerían semejanzas, otros reforzaban o debilitaban hipótesis. De esa actividad distribuida surgía una interpretación del problema. La conexión con los sistemas complejos estaba allí, incluso antes de que Mitchell ampliara formalmente su trabajo hacia ese campo.
En el fondo, representar bien un problema también forma parte de resolverlo. Una computadora puede realizar muchísimas operaciones y permanecer encerrada en una descripción poco útil. A las personas también nos pasa, aunque tenemos cierta facilidad para volver a mirar una escena y advertir que aquello que tratábamos como un detalle es, en realidad, la relación decisiva. Percibimos una figura como borde de algo, una letra como integrante de una serie o una situación desconocida a través de otra experiencia que conocemos.
Mitchell ha insistido en que la analogía no constituye una rareza intelectual reservada para acertijos. Razonamos con ella todos los días. Durante la pandemia examinó las imágenes que se utilizaron para comprender la crisis: la guerra, la tormenta, el incendio, la ola, la carrera. Ninguna era equivalente a las otras. Cada una permitía ver ciertas relaciones, disimulaba algunas y podía orientar respuestas distintas. La manera de comparar también afecta lo que hacemos.
Con Copycat, entonces, la pregunta se extiende bastante más allá de las letras. ¿Cómo selecciona una mente las semejanzas pertinentes cuando hay innumerables semejanzas posibles? ¿Cómo modifica una representación sin perder aquello que acaba de comprender?
Pienso en los problemas de programación que se resisten durante horas hasta que uno cambia la forma de describirlos. A veces el algoritmo estaba bien y era el modelo mental el que sobraba o faltaba. Por eso me sigue gustando la modestia de Copycat: su pequeño alfabeto alcanza para recordar que encontrar una respuesta y entender la relación que la vuelve posible son logros diferentes.
CAMBIÓ LA MANERA DE MIRAR LA INTELIGENCIA
La investigación de Mitchell se amplió durante su paso por la Universidad de Michigan y el Santa Fe Institute. Trabajó con John Holland, una de las figuras centrales de los algoritmos genéticos, y estudió junto con Stephanie Forrest el comportamiento de estos métodos. La inspiración proviene de la evolución: poblaciones de soluciones se modifican mediante variación, combinación, mutación y selección, explorando posibilidades sin que una sola instrucción dicte de antemano el recorrido completo.
El interés iba más allá de encontrar procedimientos eficaces de búsqueda. En la ciencia de la complejidad aparece una inquietud más general: cómo las interacciones entre unidades relativamente simples producen comportamientos colectivos difíciles de anticipar mirando una pieza aislada. Sucede en colonias de insectos, mercados, sistemas inmunes y redes neuronales, aunque las explicaciones específicas de cada caso sean muy distintas. Mitchell estudió también autómatas celulares, adaptación y emergencia, y reunió buena parte de esas preguntas en Complexity: A Guided Tour.
La palabra emergencia merece una atención particular. Permite describir una propiedad del conjunto que no resulta evidente al observar cada componente; explicar cómo se produjo exige reconstruir mecanismos y condiciones. La distinción cobra importancia cuando se habla de inteligencia artificial: al aumentar la escala de ciertos modelos se observaron capacidades que sistemas menores no mostraban con la misma claridad. Es un fenómeno digno de estudio. También puede convertirse en una explicación demasiado cómoda si la palabra emergente reemplaza las preguntas sobre mecanismos, condiciones y límites.
Mitchell está bien situada para resistir esa facilidad sin negar la sorpresa. Su formación le permite tomar en serio los comportamientos colectivos inesperados; su trabajo empírico la obliga a preguntar de dónde provienen. Además, la inteligencia humana no surge en el vacío: combina percepción, cuerpo, memoria, aprendizaje social, cultura e interacción con un entorno. Falta establecer cuáles de esos ingredientes son indispensables para ciertas capacidades y cuáles pueden organizarse por caminos distintos.
Una capacidad inesperada merece admiración. Nunca me pareció que admirar algo nos eximiera de entenderlo. Con la palabra emergencia puede ocurrir lo mismo que con una función de software que empieza a dar el resultado esperado: el éxito es una buena noticia, aunque todavía falte saber por qué funciona. La prudencia de Mitchell me resulta más convincente que el entusiasmo o el escepticismo convertidos en identidad.
QUE DISTORSIONAN LA IA
En 2021 Mitchell publicó “Why AI is Harder Than We Think”, un ensayo sobre errores de interpretación que reaparecen cada vez que la inteligencia artificial parece próxima a resolver sus dificultades fundamentales. Identificó cuatro falacias que, leídas después de la expansión de los modelos generativos, conservan una utilidad especial, aunque la tecnología ya no sea la misma que ocupaba el centro de la discusión cuando escribió el texto.
La primera falacia consiste en subestimar la dificultad de actividades humanas que realizamos sin esfuerzo aparente. Caminar por una casa, interpretar una instrucción ambigua o comprender una escena cotidiana moviliza conocimientos físicos y sociales cuya complejidad se nos escapa justamente porque los usamos todo el tiempo. La familiaridad con una habilidad suele hacernos malos jueces de lo que implica reproducirla.
Otra simplificación aparece cuando imaginamos capacidades cognitivas como piezas independientes que pueden aislarse y ampliarse sin alterar las demás. Percepción, memoria, lenguaje, planificación y sentido común se relacionan de maneras que hacen difícil separar sus contribuciones. La tercera falacia surge del vocabulario: decimos que una máquina lee, razona, aprende o comprende y esas palabras, útiles para describir operaciones, arrastran asociaciones con la experiencia humana que quizá la evidencia disponible no justifique. Finalmente está la tentación de situar todas las inteligencias sobre una única escala, como si superar cierto examen indicara una distancia mensurable respecto de una inteligencia humana general.
Basta mirar las irregularidades de los sistemas actuales para entender por qué esas advertencias importan. Un modelo puede resolver tareas complejas, programar o traducir con notable competencia y equivocarse luego ante una variación aparentemente menor. Puede elaborar una explicación persuasiva y sostener después otra incompatible. Estas diferencias no cancelan sus logros; vuelven inadecuada la idea de resumirlos en una sola cifra o en una proclamación sobre cuánto falta para alcanzar a una persona.
El ensayo apareció antes del lanzamiento público de ChatGPT. La amplitud de los sistemas posteriores obligó a actualizar muchas expectativas, incluida la de quienes se mostraban cautelosos. Mitchell ha respondido con preguntas metodológicas: qué tipo de comprensión sostiene el rendimiento, cómo reconocer una transferencia genuina y qué valor conserva una prueba cuando sus problemas, o variantes muy cercanas, pudieron formar parte de los datos de entrenamiento.
Es relativamente fácil pedir moderación en las predicciones; bastante más exigente es diseñar un experimento capaz de distinguir explicaciones rivales. Yo también puedo entusiasmarme con una demostración brillante. La incomodidad empieza cuando intento precisar qué demostró, exactamente, y qué todavía no sabemos. Esa exigencia sirve para cualquier discusión tecnológica, incluida la suya.
VIVE EN LO QUE DAMOS POR HECHO
Un ejemplo sencillo que Mitchell ha utilizado ayuda a reconocer la dificultad. Si un muñeco de nieve está junto a una calle, una persona entiende que no saldrá caminando hacia el tránsito. Un sistema de conducción debe interpretar la escena mediante sensores y modelos que permitan distinguir objetos, anticipar conductas y decidir cuáles representan un riesgo. La diferencia parece obvia, pero esa obviedad contiene una cantidad enorme de conocimiento sobre el mundo.
Aprendemos desde muy temprano que los objetos ocupan espacio, que algunas superficies sostienen a otras, que los recipientes contienen cosas y que las personas actúan con intenciones. Gran parte de estas expectativas surge de la experiencia perceptiva, corporal y social; pocas veces necesitamos formularlas como reglas. Podemos utilizarlas y corregirlas cuando el contexto lo exige. Ese conocimiento tácito participa de lo que llamamos sentido común.
Mitchell lleva años señalando una posible barrera de significado para la inteligencia artificial: el problema de pasar del manejo eficaz de patrones a una comprensión que conserve flexibilidad frente a situaciones nuevas. En 2018 y 2023, el Santa Fe Institute organizó encuentros bajo el nombre AI and the Barrier of Meaning, reuniendo a especialistas de informática, filosofía, lingüística, antropología, neurociencia, derecho y ciencia cognitiva. El encuentro se organizó alrededor de un desacuerdo que merecía ser investigado.
Los modelos de lenguaje volvieron más difícil, y más interesante, ese desacuerdo. Su competencia lingüística es innegable. Algunos investigadores interpretan que el entrenamiento sobre grandes cantidades de lenguaje permite construir representaciones comprimidas de aspectos del mundo. Otros consideran que una parte importante del rendimiento puede explicarse por regularidades estadísticas extensas sin atribuir a los sistemas una comprensión comparable a la humana. Entre esas posiciones caben grados, mecanismos y capacidades diferentes.
Mitchell evita resolver la discusión mediante una declaración solemne acerca de lo que las máquinas son o dejan de ser. Propone buscar evidencia: si se alteran los objetos, las palabras o la escena, ¿qué relaciones conserva el sistema? ¿Puede reconocer una estructura que nunca encontró bajo esa apariencia? Así, una noción tan escurridiza como comprensión empieza a estudiarse a través de capacidades concretas, aun cuando el concepto general permanezca en disputa.
Convivir con la incertidumbre así me parece razonable. La experiencia de usar sistemas que escriben con soltura invita a atribuirles más de lo que podemos verificar, mientras que sus errores invitan a negarles cualquier comprensión. Ninguno de esos reflejos me ayuda demasiado. Prefiero averiguar dónde resiste una idea cuando cambian las circunstancias; ahí la palabra entender empieza a adquirir algún contorno.
CAMBIAR LA SUPERFICIE PARA PROBAR EL CONCEPTO
En 2019 François Chollet presentó el Abstraction and Reasoning Corpus, conocido como ARC. Sus problemas utilizan grillas pequeñas de colores: el sistema recibe unos pocos ejemplos de una transformación y debe aplicar la regla a una entrada nueva. Aparecen objetos, cantidades, simetrías, relaciones espaciales y cambios de posición. El interés del diseño reside en medir si una regla abstracta puede aprenderse y utilizarse a partir de muy poca información.
Mitchell encontró en ese terreno una continuidad con Copycat. Junto con Arseny Moskvichev y Victor Vikram Odouard desarrolló ConceptARC, publicado en 2023, para organizar problemas alrededor de conceptos identificables: igualdad y diferencia, interior y exterior, arriba y abajo, centro, línea, cantidad u orden. Las tareas modifican colores, figuras, distribuciones y dificultades mientras procuran mantener reconocible el concepto puesto a prueba.
El desplazamiento es importante. Un sistema podría resolver cierto ejercicio porque aprendió asociaciones ligadas a sus colores o a una disposición frecuente. Si cambiamos esos rasgos y conservamos la relación, podemos investigar si aquello que aprendió sobrevive a la transformación. La prueba no entrega una definición definitiva de inteligencia, pero vuelve más precisa una de las preguntas que la componen: ¿puede viajar un concepto cuando cambia su apariencia?
Los resultados publicados por el equipo mostraron diferencias importantes entre participantes humanos y sistemas artificiales evaluados. En pruebas vinculadas con igualdad, por ejemplo, las personas obtuvieron rendimientos muy superiores a los de GPT-4. Más tarde, Mitchell, Alessandro Palmarini y Moskvichev compararon a humanos con GPT-4 y GPT-4V en tareas de abstracción y razonamiento. Encontraron capacidades interesantes junto con fragilidades de generalización ante distintas variaciones. Conviene leer esos resultados como evidencia de las condiciones y sistemas estudiados, no como una sentencia que pueda mantenerse idéntica después de cada nueva generación de modelos.
Ahí aparece otro problema: un benchmark también envejece. Puede ser superado por avances genuinos, o difundirse tanto que sus ejemplos terminen en el entrenamiento de los sistemas que después deberían rendirlo. Mitchell ha insistido en la necesidad de evaluaciones renovables, capaces de examinar dimensiones específicas y de distinguir lo conocido de lo verdaderamente transferido. La dificultad de una prueba no garantiza por sí sola su valor científico.
ConceptARC me parece valioso porque desplaza una costumbre muy arraigada en informática: celebrar que un programa pasó la prueba sin preguntarse hasta qué punto la prueba se parecía a aquello para lo cual lo habíamos preparado. Cambiar el decorado no es una sutileza cuando lo que queremos medir es abstracción. Y hay algo casi artesanal, después de tanta escala, en diseñar pequeñas variaciones que revelen exactamente dónde falla una idea.
VOLVIERON MÁS DIFÍCIL EL EXAMEN
Los grandes modelos de lenguaje alteraron el trabajo de quienes intentan evaluar inteligencia. Una parte considerable de Internet contiene problemas, exámenes, explicaciones, soluciones y discusiones sobre cómo resolverlos. Un sistema entrenado con cantidades enormes de ese material puede obtener un resultado sobresaliente por razones diferentes: quizá generalizó una regla, quizá reconoció un problema parecido, quizá reconstruyó una solución a partir de fragmentos conocidos. Incluso puede haber encontrado durante su entrenamiento el ejercicio que ahora aparece como novedad.
La diferencia entre esas posibilidades importa si queremos comprender qué aprendió el sistema. Los exámenes preparados para personas presuponen una historia de aprendizaje muy distinta y, al volverse públicos, pierden parte de su capacidad para sorprender a una máquina alimentada con enormes archivos. Evaluar exige entonces controlar mejor la novedad, introducir variaciones y buscar tareas que obliguen a transferir relaciones más allá de su presentación habitual.
Mitchell ha colocado esa dificultad en el centro de sus investigaciones sobre GPT-4 y razonamiento abstracto. ConceptARC forma parte de la respuesta, aunque ninguna colección cerrada pueda solucionar por sí sola el problema. También lo forman las conversaciones interdisciplinarias que impulsa desde el Santa Fe Institute. En 2024 organizó con John Krakauer un grupo de trabajo sobre la naturaleza de la inteligencia en humanos, animales y máquinas. La discusión examinaba qué dimensiones deberían compararse cuando los sistemas poseen arquitecturas y experiencias tan distintas.
En 2026, otro grupo del Instituto se concentró en la composicionalidad: la capacidad de combinar elementos conocidos para desenvolverse en escenarios nuevos. Es una preocupación familiar para quien haya seguido la trayectoria de Mitchell. Aprender una pieza abre la pregunta por cómo puede utilizarse junto con otras de una forma que no estaba prevista en los ejemplos originales. Una parte de la inteligencia humana parece residir precisamente en esa elasticidad.
El evaluador queda en una situación curiosa. Cada progreso de los modelos obliga a reconsiderar las pruebas, y cada nueva prueba revela algo sobre nuestras propias ideas acerca de la inteligencia. Medir deja de parecer una tarea de vigilancia externa al laboratorio. Pasa a formar parte de la investigación sobre qué capacidades existen y cómo se relacionan.
En programación, un test que confirma únicamente los casos previstos puede ofrecer una tranquilidad bastante engañosa. La semejanza con estos experimentos me ronda, aunque la inteligencia sea un objeto de estudio incomparablemente más complejo. La pregunta incómoda es qué aprendimos del examen cuando el sistema aprobó: si supimos construir una prueba que nos enseñara algo.
ABRE CAPACIDADES Y DEJA PREGUNTAS
El aumento de datos, parámetros y cómputo produjo mejoras extraordinarias en inteligencia artificial. Mitchell no necesita discutir esa evidencia para señalar un problema distinto: hasta dónde podemos extrapolarla. Que una familia de sistemas mejore en numerosas tareas al crecer no demuestra por sí solo cómo evolucionarán todas las capacidades que asociamos con la inteligencia, ni cuáles de sus dificultades desaparecerán mediante el mismo procedimiento.
La historia del campo invita a cierta cautela. El ajedrez, los sistemas expertos, el reconocimiento visual, la traducción y, más recientemente, el lenguaje fueron escenarios de avances muy reales. A menudo, cada conquista produjo la sensación de que se había encontrado la pieza que faltaba para resolver el problema general. Con el tiempo aparecieron dificultades nuevas, o quedó en evidencia que la capacidad conquistada describía una parte menor —aunque valiosa— de aquello que esperábamos explicar.
La escala puede seguir sorprendiendo. Precisamente por eso Mitchell insiste en que necesitamos distinguir rendimiento de explicación. Un modelo puede mejorar mucho y conservar fragilidades ante ciertas tareas de abstracción, causalidad, sentido común o transferencia. Una curva que describe un régimen observado ofrece información valiosa; transformarla en una ley universal acerca de lo que ocurrirá después exige conocer mejor los mecanismos.
Tampoco sabemos todavía lo suficiente sobre nuestra propia inteligencia. Las personas forman conceptos, integran percepción y acción, utilizan analogías y aprenden de experiencias relativamente escasas. Un niño puede reconocer ciertas regularidades con una exposición muy distinta de la que requieren muchos modelos artificiales. Esa diferencia no prueba que haya un único camino legítimo hacia la inteligencia, pero sugiere preguntas sobre eficiencia, representación y arquitectura que sería imprudente abandonar.
El trabajo de Mitchell conserva así una apertura doble. Reconoce capacidades que hace poco habrían parecido improbables y reclama explicaciones más precisas para ellas. Su inquietud es comprender qué ingredientes hacen posible una generalización flexible, sean o no iguales a los que utilizamos los seres humanos.
En esto me cuesta elegir uno de los bandos que suelen ofrecerse. La escala ha demostrado demasiado como para descartarla, y nuestras lagunas de conocimiento son demasiado grandes como para convertirla en respuesta final. Cuando una herramienta funciona mejor de lo que imaginábamos, me parece que la curiosidad debería aumentar. Sería una lástima confundir la sorpresa con la última palabra.
Una investigadora que estudia los límites de la inteligencia artificial enfrenta una dificultad particular: los sistemas que examina pueden cambiar antes de que su diagnóstico termine de circular. En 2026, modelos multimodales combinan texto, imágenes y audio; sistemas de razonamiento destinan más cómputo a problemas difíciles, y algunos agentes enlazan herramientas y memoria. Capacidades que parecían lejanas hace pocos años hoy forman parte de demostraciones corrientes. Una crítica seria está obligada a reconocer esos avances, del mismo modo que un entusiasmo serio debería reconocer sus fallas.
Mitchell responde a ese movimiento con trabajo empírico. ConceptARC, los estudios sobre GPT-4 y los encuentros dedicados a comprensión y composicionalidad muestran un esfuerzo por actualizar las preguntas cuando las respuestas cambian. Su posición sería mucho menos interesante si cada error de un modelo se utilizara como prueba definitiva de incapacidad. Lo que propone es investigar por qué ciertos resultados se sostienen y otros no.
Existe, sin embargo, una dificultad que ninguna actualización técnica resuelve por completo: comprensión reúne capacidades distintas. Entre las personas usamos esa palabra para hablar de explicar, prever, reconocer una intención, establecer analogías o actuar adecuadamente en una situación. Esas capacidades no siempre coinciden, y todavía no tenemos una teoría acabada sobre cómo se integran en nosotros. Una evaluación que pretenda medirlas puede terminar introduciendo su propia definición de lo que cuenta como inteligencia.
Mitchell intenta evitar ese círculo descomponiendo el problema en abstracción, analogía, sentido común, percepción, composicionalidad y transferencia. Esa decisión gana precisión experimental y deja un costo posible: lo que se deja fuera de la medición corre el riesgo de quedar fuera de la conversación. Hay una tensión inevitable entre diseñar pruebas exigentes y aceptar que distintas arquitecturas podrían desplegar formas de comprensión que no se parezcan demasiado a las nuestras.
También conviene mirar las instituciones. Mitchell trabaja desde espacios de investigación y debate como el Santa Fe Institute, mientras buena parte de los sistemas que evalúa se desarrolla en un campo donde cuentan la escala industrial, los recursos de cómputo y la competencia por exhibir resultados. Los benchmarks pueden facilitar comparaciones y, al mismo tiempo, convertirse en objetivos que la industria aprende a optimizar. Que un sistema mejore en una prueba merece reconocimiento, aunque el prestigio del puntaje nunca debería reemplazar la pregunta por aquello que mide. La ciencia y la presentación comercial de sus logros no siempre tienen las mismas urgencias.
Es el punto donde necesito ser más cuidadoso con Mitchell y también conmigo. Desconfío de los exámenes demasiado fáciles. Un examen construido a imagen de nuestras propias maneras de razonar puede confundir diferencia con fracaso. Su insistencia en precisar conceptos deja lugar para discutirlos; no los clausura. Tal vez la mejor prueba sea aquella que, además de examinar al sistema, permita descubrir dónde estaba mal formulada nuestra pregunta.
Hay una continuidad poco común en la trayectoria de Melanie Mitchell. Copycat intentaba descubrir qué relación podía trasladarse de una secuencia de letras a otra. Los algoritmos genéticos y la ciencia de la complejidad ampliaron su atención hacia la adaptación, las interacciones locales y los comportamientos colectivos. Más adelante, la visión computacional y los grandes modelos trajeron escenarios técnicos diferentes, pero conservaron una inquietud semejante: cómo reconocer una estructura y utilizarla allí donde la apariencia ya no ofrece el mismo camino.
Su libro Artificial Intelligence: A Guide for Thinking Humans y el ensayo “Why AI is Harder Than We Think” discutieron la distancia entre los resultados de las máquinas y las interpretaciones que hacemos de esos resultados. ConceptARC buscó convertir parte de esa distancia en una pregunta experimental. Los trabajos posteriores sobre GPT-4, comprensión y composicionalidad continúan el esfuerzo, ahora ante sistemas capaces de responder correctamente una variedad de problemas que habría sido difícil anticipar.
Eso vuelve más exigente el trabajo de evaluación. Algunas pruebas quedan superadas; otras se vuelven conocidas y dejan de servir. Hay que diseñar variaciones, precisar conceptos y revisar los supuestos con los que comparamos máquinas, animales y personas. La pregunta que insiste desde los años ochenta —qué aprendió realmente el sistema— adquiere nuevas dificultades cuando el sistema fue entrenado con una parte considerable de los ejemplos disponibles en nuestra cultura.
No estoy seguro de que alguna vez tengamos un examen único capaz de resolver el asunto. La inteligencia incluye capacidades diversas, y podemos encontrar formas nuevas que obliguen a cambiar incluso las categorías de observación. Pero esa incertidumbre no invalida el programa de Mitchell; al contrario, muestra por qué resulta necesario. Podemos celebrar una respuesta correcta y seguir preguntando qué sucede cuando falta la pista conocida, cuando una regla debe combinarse con otra o cuando el contexto cambia lo suficiente para que el parecido superficial deje de ayudarnos.
La comprensión se juega fuera del ejemplo, dice el título de este ensayo. Quisiera conservar esa idea sin convertirla en una frontera inmóvil entre humanos y máquinas. Lo verdaderamente difícil será saber reconocer una transferencia cuando ocurra, aunque no haya ocurrido del modo que esperábamos. Mitchell nos deja una herramienta para aproximarnos a esa dificultad: cambiar el problema y prestar atención, incluso a las respuestas que nos obliguen a cambiar de pregunta.
MATERIALES DE REACCIÓN
ABSTRACCIÓN · ANALOGÍA · GENERALIZACIÓN · SENTIDO COMÚN · COPYCAT · COMPLEJIDAD · EMERGENCIA · REPRESENTACIÓN · CONCEPTARC · ARC · COMPOSICIONALIDAD · COMPRENSIÓN · EVALUACIÓN · INTELIGENCIA · TRANSFERENCIA
FUENTES PRINCIPALES
- Santa Fe Institute. Perfil de Melanie Mitchell.
- Santa Fe Institute. “Melanie Mitchell joins Fractal Faculty”. 14 de julio de 2021.
- Mitchell, Melanie. Complexity: A Guided Tour. Oxford University Press, 2009.
- Mitchell, Melanie. Artificial Intelligence: A Guide for Thinking Humans. Farrar, Straus and Giroux, 2019; nueva edición con prefacio actualizado.
- Mitchell, Melanie. “Why AI is Harder Than We Think”. 2021.
- Mitchell, Melanie. “How the Analogies We Live by Shape our Thoughts”. Santa Fe Institute, 2020/2021.
- Santa Fe Institute. “AI and the Barrier of Meaning 2”. 2023.
- Santa Fe Institute. “Humans and AI: The many dimensions of understanding”. 15 de mayo de 2023.
- Moskvichev, Arseny; Odouard, Victor Vikram; Mitchell, Melanie. “The ConceptARC Benchmark: Evaluating Understanding and Generalization in the ARC Domain”. Transactions on Machine Learning Research, 2023.
- Santa Fe Institute. “Study: Visual Analogies for AI”. 25 de septiembre de 2023.
- Mitchell, Melanie; Palmarini, Alessandro B.; Moskvichev, Arseny. “Comparing Humans, GPT-4, and GPT-4V On Abstraction and Reasoning Tasks”. 2023.
- Santa Fe Institute. “Investigating the nature of intelligence”. 10 de septiembre de 2024.
- Santa Fe Institute. Foundations of Intelligence in Natural and Artificial Systems.
- Santa Fe Institute. “Smart parts for smart wholes”. 2026.
- Santa Fe Institute. Podcast, “AI’s changing seasons”.
COMPLETAN LA SÉPTIMA ENTREGA: