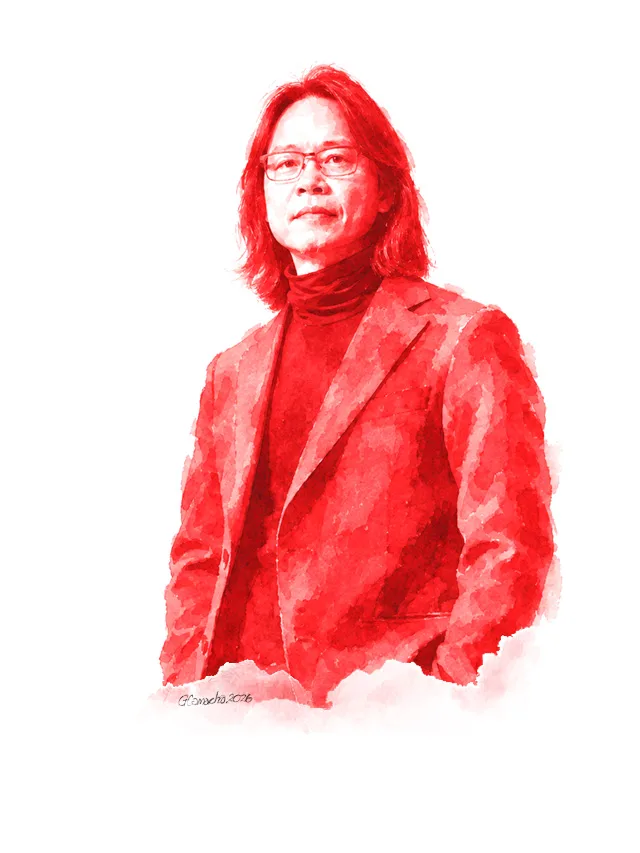
Alguien tuvo que enseñarle a la máquina
La inteligencia artificial también descansa sobre trabajo precario, invisible y mal pagado. Mirar solamente el salario, sin embargo, todavía deja algo afuera: quienes producen los datos también producen las categorías con las que una máquina aprende a ordenar el mundo. Milagros Miceli investiga esa zona donde el trabajo se convierte en verdad de referencia.
Fuentes principales: trabajos de Milagros Miceli sobre producción de datos para aprendizaje automático; The Data-Production Dispositif; Studying Up Machine Learning Data; Documenting Data Production Processes; Data Workers’ Inquiry; investigaciones recientes sobre autoridad epistémica de los trabajadores.
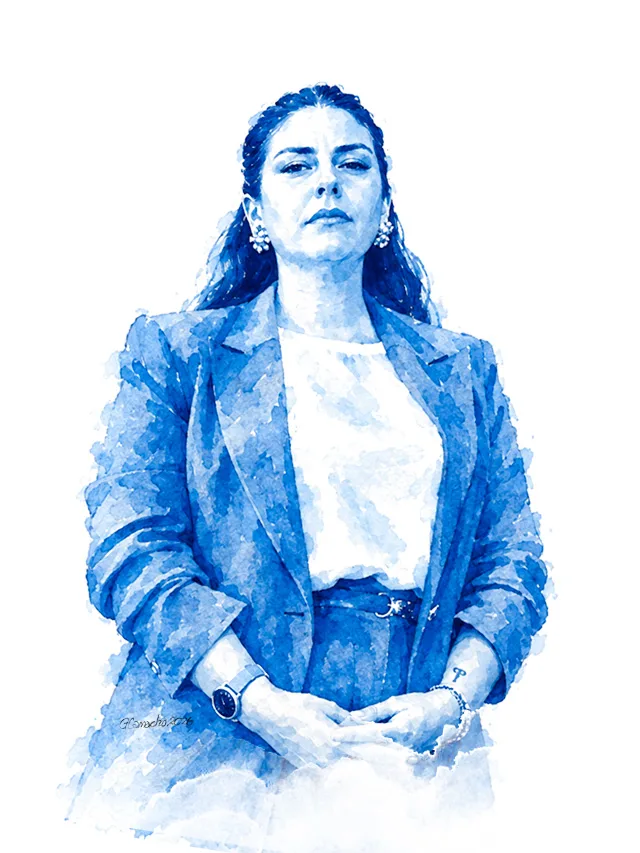
«Poner herramientas de investigación en las manos de quienes trabajan.»
— Milagros Miceli, “Cómo hicimos Data Workers’ Inquiry”, 2025.
Hay una expresión particularmente eficaz en inteligencia artificial: ground truth. Verdad de base, verdad terreno, una referencia suficientemente confiable como para comparar la respuesta de un sistema con aquello que debería haber respondido.
La expresión suena como si esa verdad hubiera estado esperando dentro de los datos y alguien se limitara a recogerla. Milagros Miceli lleva años estudiando el trabajo que ocurre antes: personas que reciben instrucciones, miran imágenes, leen textos, escuchan audios, asignan categorías, resuelven ambigüedades y producen aquello que después aparecerá en un dataset como una etiqueta limpia. Empresas que redactan manuales. Plataformas que distribuyen tareas. Interfaces que permiten unas respuestas y no otras. Métricas que premian acuerdo, velocidad o productividad.
La “verdad” que aprende una máquina tiene historia laboral, y también relaciones de poder. Esa es la hipótesis que Miceli convierte en método: no mirar el dataset terminado sino el proceso que lo hizo posible, con sus jerarquías, sus urgencias y sus silencios.
NO LLEGA TERMINADO
Una fotografía no contiene por sí sola la palabra “peatón”. Un audio no trae incorporada su transcripción. Una frase no incluye una etiqueta universal que indique si expresa alegría, amenaza, ironía o insulto. Para que esos materiales puedan alimentar ciertos sistemas de aprendizaje automático, alguien debe convertirlos en categorías utilizables.
Ese trabajo suele aparecer en la documentación técnica como una fase previa: preparación, limpieza o anotación de datos. Miceli propone invertir la perspectiva. La producción de datos no es una antesala irrelevante del modelo; allí se toman decisiones sobre significado, se define qué diferencias importan, cuáles se ignoran y qué interpretación se convierte en referencia correcta.
Cuando el dataset termina, esas decisiones se vuelven difíciles de ver. La etiqueta parece pertenecer a la imagen y el trabajo que la puso allí desaparece. El resultado se presenta como si la categoría hubiera estado en el mundo, esperando a que alguien la anotara.
Hay algo de esta operación que me resulta familiar en el trabajo con archivos. Un documento catalogado parece describirse a sí mismo, pero detrás hay alguien que decidió qué campo llenar, qué palabra usar y qué hacer con lo que no entraba en ninguna categoría. Con los años, esa decisión se naturaliza y el catálogo empieza a leerse como si fuera el mundo. La diferencia es que un dataset de entrenamiento se usa para decidir cosas sobre personas.
Buena parte de la discusión sobre inteligencia artificial adoptó la palabra sesgo para describir resultados injustos o representaciones incompletas. Miceli, Julian Posada y Tianling Yang propusieron una pregunta más incómoda: ¿por qué hablar de sesgo cuando en muchos casos estamos hablando de poder?
El cambio no es puramente terminológico. “Sesgo” puede sugerir una desviación respecto de un punto neutral: encontramos el error, equilibramos los datos, corregimos la muestra. Una perspectiva centrada en poder obliga a preguntar quién define la categoría, quién redacta las instrucciones, qué intereses empresariales organizan el trabajo, qué desigualdades históricas llegan al dataset y qué margen tiene quien etiqueta para discutir una orden.
La diferencia aparece con claridad en una tarea ambigua. Si el trabajador interpreta el material de una manera y la guía exige otra, ¿cuál de las dos se convierte en verdad de referencia? La respuesta no depende solamente de quién entiende mejor la escena. También depende de quién paga y quién puede rechazar el trabajo del otro.
Me parece una distinción necesaria y, al mismo tiempo, difícil de sostener en público. “Sesgo” suena a problema técnico y permite hablar de soluciones; “poder” suena a conflicto y obliga a nombrar intereses. No es casual que la primera palabra haya ganado el vocabulario de la industria. La segunda pregunta quién decide, y esa pregunta no siempre tiene una respuesta que convenga mostrar.
DE PRODUCCIÓN DE DATOS
En The Data-Production Dispositif, Miceli y Posada estudiaron plataformas en Venezuela y una empresa de tercerización en Argentina. Analizaron documentos de instrucciones, entrevistaron trabajadores, gerentes y solicitantes y realizaron observación participante. Para describir lo que encontraron recurrieron a la noción foucaultiana de dispositivo.
El dato no se produce mediante una sola orden. Se produce dentro de un conjunto de discursos, interfaces, reglas, métricas y relaciones laborales que orientan la interpretación. Una instrucción puede codificar la visión del mundo del cliente. Una interfaz puede impedir que el trabajador explique por qué ninguna categoría disponible resulta adecuada. Una métrica de productividad puede volver costoso detenerse frente a una ambigüedad. La dependencia económica puede convertir una discrepancia en obediencia.
Nada de eso aparece necesariamente en el archivo final. El dataset conserva el resultado y pierde buena parte de las condiciones que lo hicieron posible. Lo que queda es una etiqueta correcta según una regla, sin memoria de la discusión que la produjo.
La palabra “dispositivo” puede sonar grandilocuente para describir una planilla y un manual de instrucciones. Describe bien, sin embargo, lo que vi en tantos sistemas: reglas que nadie escribió en un solo lugar y que, aun así, terminan decidiendo qué se puede hacer. En el trabajo de datos, esas reglas tienen además un costo económico inmediato para quien las obedece.
NO SOLO EL PRODUCTO
La respuesta habitual frente a datasets opacos ha sido documentarlos mejor: quién los creó, qué contienen, para qué fueron diseñados, cuáles son sus límites. Miceli y sus colaboradores propusieron ampliar esa lógica. No alcanza con documentar el dataset: también hay que documentar la producción del dataset.
Durante más de dos años trabajaron con trabajadores de empresas en Argentina y Bulgaria para diseñar formas de registrar tareas, equipos, instrucciones, pagos, cambios y retroalimentación. El objetivo no era agregar burocracia sino conservar parte del contexto que normalmente se pierde cuando el dato viaja desde quien lo produce hasta quien entrena un modelo.
La diferencia puede parecer administrativa, pero cambia la posibilidad de auditoría. Un dataset puede decir de dónde provienen sus imágenes y seguir ocultando que quienes las etiquetaron recibieron instrucciones contradictorias, no pudieron consultar al cliente o fueron penalizados por detenerse demasiado tiempo. La transparencia sobre el objeto no reemplaza la transparencia sobre el trabajo.
Esa es una lección que excede a la IA. Cualquier institución que produce registros tiende a documentar el resultado y a olvidar el proceso, porque el proceso incluye conflictos que conviene no dejar por escrito. Pedir documentación del trabajo es, en el fondo, pedir que la institución se mire mientras trabaja.
PUEDE EXTRAER
Existe otra incomodidad en el recorrido de Miceli: investigar trabajo precario no garantiza que la investigación deje de ser extractiva. Un académico puede viajar, entrevistar personas, publicar un artículo, construir una carrera y abandonar el lugar con una descripción mucho más valiosa para su institución que para quienes aportaron las experiencias.
Data Workers’ Inquiry nace en parte de esa tensión. El proyecto adapta la tradición de la Workers’ Inquiry para que trabajadores de datos puedan participar como investigadores de sus propias condiciones, formular preguntas, producir informes y discutir interpretaciones. En trabajos recientes, Miceli y sus colegas llaman a esto autoridad epistémica de los trabajadores.
La expresión merece cuidado. No significa que la experiencia individual sea infalible ni que reemplace cualquier otra forma de conocimiento. Significa que ciertas relaciones de trabajo no pueden entenderse completamente si quienes las viven solo aparecen como fuentes de testimonios administrados por otros. Investigar el trabajo también exige discutir quién investiga a quién.
Reconozco esa incomodidad en mi propio oficio. Escribir sobre el trabajo de otros es una forma de producir valor, y no siempre ese valor vuelve a quienes lo hicieron posible. La diferencia entre una investigación extractiva y una colaborativa no está en las intenciones del investigador sino en quién define las preguntas, quién firma y quién conserva lo producido.
QUE EL MODELO NO REGISTRA
Quien etiqueta miles de ejemplos aprende dónde falla una instrucción. Sabe qué categorías se confunden, qué casos obligan a improvisar, cuándo una guía fue escrita por alguien que no conoce el contexto local y qué cambios en la plataforma alteran la calidad del trabajo. Ese conocimiento puede no quedar registrado porque el sistema fue diseñado para recibir etiquetas, no comentarios sobre la etiqueta.
Miceli insiste en que la calidad de los datos y las condiciones laborales no son problemas separados. Una cadena que trata al trabajador como ejecutor reemplazable también desperdicia información sobre el propio sistema. Si la persona no puede devolver dudas, cuestionar categorías o explicar excepciones, una parte del conocimiento producido durante la tarea se pierde.
La paradoja es fuerte. Las empresas contratan seres humanos precisamente porque el mundo contiene ambigüedades que la máquina todavía no resuelve. Después diseñan procesos que intentan reducir a esos humanos a comportamiento mecánico.
La paradoja no es un accidente, sino el resultado de una forma de organizar el trabajo que necesita juicio y, al mismo tiempo, desconfía de él. Se paga por interpretar y se penaliza la interpretación que se aparta de la guía. El sistema quiere la inteligencia del trabajador sin la autonomía que esa inteligencia requiere. Ahí está lo que me incomoda.
A UNA CADENA GLOBAL
La investigación de Miceli tiene una característica importante para La Intemperie: una parte de su trabajo sobre producción de datos comenzó mirando América Latina, incluida Argentina, pero no se quedó allí. Data Workers’ Inquiry reúne experiencias de distintos países y tipos de trabajo. En Buenos Aires, Miceli investigó a jóvenes que etiquetaban datos en barrios populares. En otros contextos encontró refugiados y trabajadores vinculados a tareas que terminaban alimentando sistemas de vigilancia o aplicaciones militares.
La geografía modifica el trabajo. Cambian salarios, idiomas, contratos, costos de vida, capacidad de organización y relación con las empresas. Lo que permanece es una cadena global que puede distribuir tareas allí donde encuentra mano de obra disponible y mantener lejos del producto final las condiciones concretas de esa producción.
Por eso “trabajo invisible” describe algo, pero no todo. Muchas veces el trabajo es perfectamente visible para quien lo compra. Lo invisible es su lugar en el relato público sobre la inteligencia artificial.
Esa distinción me obliga a revisar la manera en que hablamos de estos temas en Argentina. Decir “trabajo invisible” puede sonar a que nadie lo ve, cuando en realidad lo ven el contratista, la plataforma y el cliente. Lo que no se ve es la relación entre esa tarea y el producto que después se celebra como un avance técnico. La invisibilidad es una decisión narrativa, no una propiedad del trabajo.
Poner el foco en trabajo y poder puede generar su propia reducción. No todos los problemas de un sistema de IA se explican por precariedad laboral. Un dataset puede producirse bajo buenas condiciones y conservar límites técnicos, estadísticos o conceptuales. Un proceso participativo tampoco garantiza por sí solo categorías justas ni elimina conflictos entre comunidades.
Existe además una tensión difícil entre mejorar el trabajo de datos y cuestionar una industria que depende de multiplicarlo. Profesionalizar la anotación puede reconocer habilidades y derechos; también puede estabilizar cadenas de producción que continúan distribuyendo de manera muy desigual valor y decisión. Miceli no resuelve esa contradicción con una consigna. Su aporte está en hacerla visible dentro del objeto técnico.
Cuando una empresa dice que necesita “mejores datos”, la pregunta ya no puede terminar en el dataset. Hay que seguirla hasta las personas, contratos, instrucciones e instituciones que producen aquello que llamamos mejor.
La pertenencia académica de Miceli —el Weizenbaum Institute, la publicación en revistas del campo— también sitúa su argumento. Su trabajo circula en espacios donde la crítica es escuchada y, a la vez, donde el conocimiento producido corre el riesgo de quedarse dentro del circuito académico. La pregunta por la autoridad epistémica de los trabajadores también la alcanza a ella: quién habla, desde dónde y para quién.
Prefiero esa incomodidad: me parece más honesta que cualquier denuncia cerrada. La crítica al trabajo de datos no se sostiene si solamente señala culpables; se sostiene si logra mostrar cómo el propio sistema produce las condiciones que después lamenta. Y eso incluye a quienes investigamos, escribimos y usamos esos sistemas.
Milagros Miceli sirve como precursora porque desplaza la discusión sobre inteligencia artificial hacia una zona que durante mucho tiempo fue tratada como servicio auxiliar. La máquina aprende de datos, pero los datos no caen del cielo. Alguien decide qué recolectar, alguien escribe una guía, alguien mira un caso dudoso, alguien transforma una interpretación en etiqueta, alguien acepta —o no puede rechazar— las condiciones bajo las cuales esa tarea debe realizarse.
En ese recorrido se produce algo más que información para una red neuronal. Se produce una versión operativa del mundo. La pregunta por la inteligencia artificial entonces cambia de escala: no alcanza con observar el modelo y preguntar qué sabe, también hay que mirar hacia atrás y preguntar quién tuvo autoridad para enseñárselo.
Queda por resolver si esa autoridad puede redistribuirse sin que la industria absorba la crítica y la convierta en una nueva certificación. La documentación del trabajo, la participación de los trabajadores y la auditoría de los procesos son herramientas valiosas; también pueden convertirse en sellos de calidad que dejen intactas las jerarquías que dicen corregir.
MATERIALES DE REACCIÓN
GROUND TRUTH · TRABAJO DE DATOS · PODER · ETIQUETADO · DISPOSITIVO · DOCUMENTACIÓN · AUTORIDAD EPISTÉMICA · PLATAFORMAS · PRECARIEDAD · INTERPRETACIÓN · INVESTIGACIÓN · IA ---
FUENTE PRINCIPAL
Miceli, Milagros; Posada, Julian. “The Data-Production Dispositif”. Proceedings of the ACM on Human-Computer Interaction, 2022.
Miceli, Milagros; Posada, Julian; Yang, Tianling. “Studying Up Machine Learning Data: Why Talk About Bias When We Mean Power?”. Proceedings of the ACM on Human-Computer Interaction, 2022.
Miceli, Milagros; Yang, Tianling; Alvarado García, Adriana; et al. “Documenting Data Production Processes: A Participatory Approach for Data Work”. Proceedings of the ACM on Human-Computer Interaction, 2022.
Miceli, Milagros; Dinika, Adio-Adet; Kauffman, Krystal; et al. “Methodological Considerations for Centering Workers’ Epistemic Authority in AI Research”. AAAI/ACM AIES, 2025.
Data Workers’ Inquiry. “How We Made Data Workers’ Inquiry”, 2025.
Weizenbaum Institute. Perfil de Milagros Miceli.
Partenio, Flora. “El detrás de escena de la IA: perspectivas innovadoras de investigación. Entrevista a Milagros Miceli”. Papeles de Trabajo, 2025.
Afiliación actual: Profesora de Ciencias de la Computación y titular de la cátedra ABSA-UP en Data Science
COMPLETAN LA CUARTA ENTREGA:
Publicado
Alguien tuvo que enseñarle al sistema qué mirar, qué nombrar y qué borrar.
Joan Kinyua
Data Labelers Association of Kenya