Publicado
Alguien tuvo que enseñarle al sistema qué mirar, qué nombrar y qué borrar.
Joan Kinyua
Data Labelers Association of Kenya
Una lengua puede ser hablada por millones de personas y seguir siendo “de bajos recursos” para una máquina. El problema no está en la lengua: está en los datos, las herramientas, la inversión y las comunidades que la tecnología decidió mirar. Vukosi Marivate trabaja en esa distancia entre una capacidad presentada como universal y las condiciones concretas que la hacen funcionar para unos mejor que para otros.
Fuentes principales: trabajos de Vukosi Marivate y colaboradores sobre procesamiento de lenguas africanas; Masakhane; Universidad de Pretoria y AfriDSAI; conferencia inaugural Beyond the Symbols; materiales recientes sobre soberanía y ecosistemas africanos de inteligencia artificial.
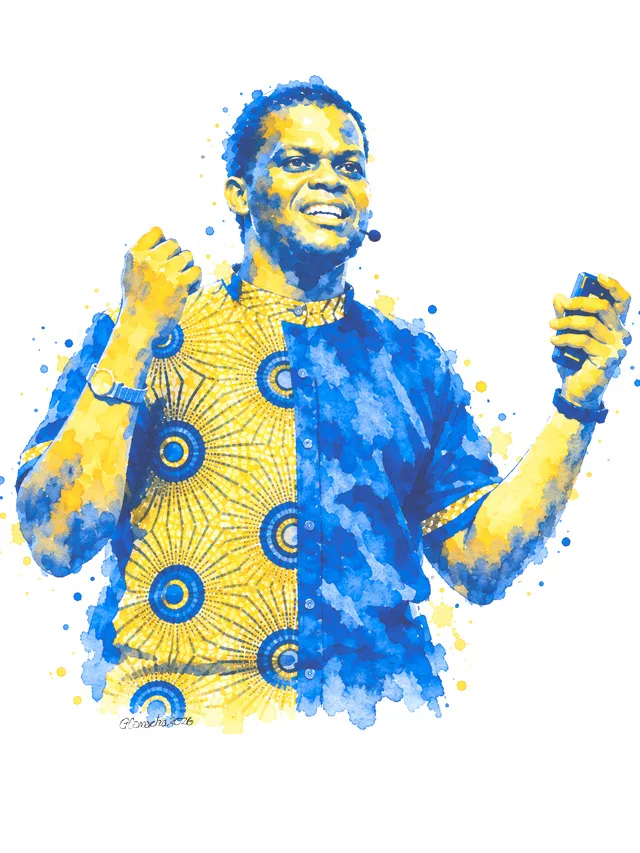
«El procesamiento del lenguaje debe tratarse como un problema adaptativo: requiere innovación técnica, pero también equidad, participación y relevancia cultural.»
— Vukosi Marivate, conferencia inaugural “Beyond the Symbols”, University of Pretoria, 2025.
Una inteligencia artificial puede presumir de hablar muchos idiomas y tropezar apenas sale del corredor lingüístico donde se acumularon la mayor parte de sus datos, sus pruebas y su inversión. La escena es conocida para cualquiera que haya usado un traductor automático con una lengua que no sea inglesa: el sistema responde, pero lo hace como quien recita una frase aprendida sin entender del todo la situación.
La expresión lengua de bajos recursos parece describir una propiedad del idioma. No la describe. Habla de otra cosa: cuántos textos fueron digitalizados, cuántos corpus fueron anotados, qué herramientas existen, quién pagó por construirlas, qué investigadores pudieron trabajar con ellas y qué lugar ocupó esa lengua en las prioridades de una industria.
Vukosi Marivate trabaja precisamente en esa distancia. Su recorrido combina investigación en aprendizaje automático y procesamiento del lenguaje natural, construcción de conjuntos de datos, formación de investigadores y creación de instituciones. Profesor de Ciencias de la Computación y titular de la cátedra de Data Science de la Universidad de Pretoria, es además cofundador del Deep Learning Indaba, investigador principal vinculado a Masakhane, cofundador de Lelapa AI y director fundador del African Institute for Data Science and Artificial Intelligence, AfriDSAI.
No se trata solamente de conseguir que una máquina traduzca mejor, sino de decidir quién puede participar en la construcción de aquello que después llamaremos inteligencia. Esa es la diferencia entre una política de accesibilidad y una discusión sobre poder.
En procesamiento del lenguaje natural, llamar low-resource a una lengua sirve para señalar una carencia técnica: faltan corpus, anotaciones, herramientas, benchmarks o modelos entrenados con suficiente calidad. La etiqueta es útil para describir un estado de la infraestructura.
El problema comienza cuando parece trasladar esa escasez a la lengua misma. Muchas lenguas africanas tienen comunidades extensas, tradiciones orales y escritas, variaciones dialectales, literatura, prensa, radio, conversación cotidiana y conocimiento acumulado durante generaciones. Lo que escasea no es necesariamente el lenguaje: escasea su conversión al formato que una determinada infraestructura computacional sabe consumir.
Ese desplazamiento cambia la pregunta. Si la carencia estuviera en la lengua, la solución consistiría en adaptarla a una tecnología ya terminada. Si la carencia está en la infraestructura, también podemos discutir qué tecnología construir, con quién y bajo qué condiciones.
La investigación de Marivate trabaja desde esa segunda posibilidad. No espera que las lenguas lleguen dócilmente al modelo; obliga al modelo, a los datos y a la comunidad de investigación a moverse hacia ellas.
Hay una trampa en el lenguaje técnico que conozco bien. Una categoría que en principio describe un dato termina pareciendo una propiedad de aquello que se mide, y entonces la discusión se desplaza sin que nadie lo note. “Bajos recursos” suena a que la lengua tiene poco, no a que le falta infraestructura. Me interesa la insistencia de Marivate en invertir esa lectura, porque devuelve la discusión al terreno donde puede cambiar algo.
Durante años, buena parte del avance del procesamiento automático del lenguaje se apoyó en grandes cantidades de texto disponibles en unas pocas lenguas. Esa abundancia facilitó métricas, competencias, herramientas y modelos que luego se convirtieron en referencia para todo el campo. La desigualdad inicial empezó a producir una segunda desigualdad: aquello que tenía más datos atraía más investigación, aquello que atraía más investigación generaba mejores herramientas, y las mejores herramientas volvían todavía más rentable seguir trabajando sobre las mismas lenguas.
Marivate participó en proyectos que intentan romper ese círculo. El trabajo de Masakhane sobre traducción automática creó benchmarks y conjuntos de datos para decenas de lenguas africanas mediante una metodología participativa. Más tarde, proyectos como MasakhaNER ampliaron recursos de reconocimiento de entidades nombradas y permitieron estudiar cómo funcionan —y dónde fallan— los modelos multilingües cuando se los desplaza hacia contextos africanos.
No es un detalle técnico menor. Una persona, una ciudad, una institución o un acontecimiento que un sistema no sabe reconocer tampoco entra de la misma manera en buscadores, clasificadores, asistentes o herramientas de análisis. La representación computacional empieza mucho antes de la interfaz donde vemos el resultado: empieza en aquello que consiguió entrar en el conjunto de datos.
Esa idea tiene una consecuencia incómoda para cualquiera que trabaje con archivos. Un dataset parece una imagen del mundo, pero es una selección de aquello que alguien consideró registrable. Cuando esa selección se repite en todos los proyectos, el sesgo deja de ser un error y se convierte en paisaje. Me pregunto cuántas cosas quedan afuera de nuestros sistemas no porque no existan, sino porque nunca entraron en la planilla.
Masakhane introdujo otra alteración importante: no limitar la investigación a pequeños equipos que recolectan material lingüístico desde afuera. En su trabajo sobre traducción de lenguas de bajos recursos, decenas de participantes contribuyeron con conocimiento lingüístico, construcción de datasets, evaluación y experimentación. Algunas de esas personas no provenían de trayectorias académicas tradicionales en procesamiento del lenguaje natural.
La operación cambia quién puede producir conocimiento técnico. Quien habla una lengua no es simplemente proveedor de ejemplos para que otro investigador construya el sistema. Puede participar en la definición del problema, detectar errores que una métrica no ve, decidir qué variaciones importan y contribuir al modelo que finalmente será evaluado.
Eso no elimina las asimetrías entre universidades, empresas, financiadores y comunidades. Modifica, eso sí, el lugar asignado a quienes durante mucho tiempo aparecieron al final de la cadena como “usuarios”. La lengua deja de ser materia prima, y sus hablantes pueden convertirse en investigadores, diseñadores y evaluadores de la tecnología que la procesa.
La palabra “participación” puede terminar siendo un sello. He visto proyectos donde se consulta a la comunidad para legitimar una decisión ya tomada, y el resultado se presenta como colaborativo. La diferencia con lo que describe Masakhane no está en el adjetivo sino en la distribución del trabajo y del crédito. Si el que habla la lengua sigue siendo una fuente de datos y no un autor, la participación es decorativa.
En su conferencia inaugural, Marivate propuso pensar el procesamiento del lenguaje natural como un problema adaptativo. La formulación evita una receta demasiado fácil: juntar más datos, entrenar un modelo más grande y suponer que la diferencia desaparecerá.
Las lenguas cambian según región, edad, contexto, préstamos, registro, escritura y uso. Los objetivos también cambian. Un sistema pensado para traducción no enfrenta exactamente los mismos problemas que uno destinado a salud, educación, servicios públicos, búsqueda o conversación. Además, cada comunidad define de manera distinta qué error resulta tolerable y cuál destruye el sentido.
Por eso la adaptación no es simplemente fine-tuning. Incluye decisiones sobre datos, participación, evaluación, licencias, infraestructura y pertinencia cultural. Un modelo puede obtener una mejora estadística y seguir siendo poco útil para quienes deberían utilizarlo.
Marivate insiste en una idea sencilla y bastante incómoda para la lógica de escala: una solución que funciona en otro lugar no se vuelve universal por haber sido desplegada en todas partes. La escala puede mejorar un promedio y, al mismo tiempo, empeorar la experiencia de quienes quedan en los márgenes de ese promedio.
Ahí me cuesta aceptar la comodidad de las métricas. Un número que sube parece una buena noticia, y a veces lo es. La adaptación, en cambio, se juega en casos que ninguna métrica agregada registra: la frase que el sistema traduce mal y nadie corrige porque no hay quien revise, el nombre propio que se pierde, la variante que se considera error. La calidad también se mide en esos detalles.
La escasez de datos suele producir una respuesta automática: hay que abrir más datasets. Compartir información lingüística, sin embargo, no es un gesto neutral cuando esa información proviene de comunidades con poca capacidad para decidir cómo será utilizada, combinada o comercializada.
En su trabajo reciente, Marivate ha defendido la construcción de recursos abiertos al mismo tiempo que participa en discusiones sobre licencias y marcos capaces de proteger datos comunitarios. En Beyond the Symbols presentó, entre otros ejemplos, iniciativas como NOODL y Esethu vinculadas a esa preocupación.
La tensión no tiene solución sencilla. Cerrar completamente los datos puede impedir que investigadores con pocos recursos participen. Abrirlos sin condiciones puede facilitar que organizaciones mucho más poderosas capturen el trabajo colectivo, lo incorporen a modelos comerciales y devuelvan poco o nada a quienes lo produjeron. La soberanía sobre los datos empieza entonces a parecerse menos a una cerradura y más a una negociación sobre derechos, reciprocidad y capacidad de decisión.
Ese punto me parece el más difícil de traducir a una política. “Abrir” y “cerrar” son posiciones fáciles de defender en abstracto; la pregunta interesante es quién decide las condiciones y quién puede hacerlas cumplir. Sin esa discusión, la apertura puede ser tan extractiva como el cercamiento.
Otra característica del trabajo de Marivate es que la unidad de análisis rara vez termina en el modelo. Deep Learning Indaba nació para fortalecer una comunidad africana de aprendizaje automático. Masakhane construyó redes alrededor de las lenguas. Lelapa AI intenta desarrollar productos desde el continente. AfriDSAI reúne investigación, formación y colaboración institucional desde la Universidad de Pretoria.
En 2026 Marivate describió la necesidad de un ecosistema circular: formar talento, construir capacidad local, desplegar soluciones situadas y reinvertir parte del valor generado para sostener a la siguiente generación de investigadores y constructores. La palabra circular importa. Un ecosistema que solo forma personas para que las absorban centros tecnológicos externos puede producir talento sin acumular capacidad. Uno que solo consume modelos creados en otros lugares puede incorporar tecnología sin adquirir poder para modificarla.
Construir inteligencia artificial también consiste en construir las instituciones capaces de discutirla, mantenerla y transformarla. Esa frase podría sonar a consigna de política científica, pero describe una diferencia material: un país puede tener usuarios de IA y no tener capacidad para decidir qué IA se usa, cómo se evalúa y quién gana con ella.
Me interesa esa idea de circularidad porque rompe con una imagen lineal del desarrollo. Durante mucho tiempo pensamos la tecnología como una escalera: se sube un peldaño y se pasa al siguiente. Un ecosistema se parece más a un circuito, donde lo que se produce vuelve a alimentar las condiciones de producción. Si ese circuito se corta, la formación se convierte en exportación de personas.
En 2026 Marivate fue incorporado al Panel Científico Internacional Independiente sobre Inteligencia Artificial de las Naciones Unidas. El desplazamiento parece enorme: de datasets y lenguas de bajos recursos a una instancia global de evaluación científica. En realidad, la conexión es bastante directa.
Si los sistemas de IA se evalúan únicamente desde los lugares donde fueron creados, muchos de sus límites aparecerán tarde o directamente no aparecerán. Las fallas lingüísticas, las dependencias de infraestructura, los costos de acceso a cómputo y la concentración de capacidad científica forman parte de los riesgos y oportunidades de la tecnología tanto como las arquitecturas de los modelos.
Una gobernanza verdaderamente internacional no se completa agregando representantes a una mesa ya diseñada. También necesita incorporar problemas que esa mesa no habría formulado por sí sola. La diferencia entre ampliar la representación y ampliar la agenda es la diferencia entre una foto más diversa y una discusión distinta.
Desconfío de las mesas globales, aunque reconozco que son uno de los pocos lugares donde esas preguntas pueden circular. El riesgo es que la participación se convierta en legitimación: alguien del Sur Global firma el documento y el documento sigue diciendo lo mismo. La prueba no es quién está sentado, sino qué problemas nuevos aparecen en el texto final.
Hablar de “IA africana” puede convertirse rápidamente en otra simplificación. África no es una unidad lingüística, cultural, económica ni tecnológica. Tiene miles de lenguas, marcos regulatorios distintos, capacidades científicas desiguales y relaciones muy diferentes con empresas, universidades y potencias tecnológicas. Una apelación demasiado cómoda a lo “local” puede borrar esa diversidad con la misma facilidad con que antes la borraba la palabra “global”.
La soberanía tecnológica tampoco resuelve por sí sola quién controla la tecnología dentro de cada territorio. Una infraestructura puede ser producida localmente y seguir concentrando poder, excluyendo comunidades o reproduciendo jerarquías. La bandera nacional no garantiza una distribución más justa de la capacidad técnica.
El aporte de Marivate resulta más interesante cuando no se lo convierte en una consigna identitaria. Su trabajo muestra algo más concreto: los sistemas funcionan mejor cuando quienes conocen los contextos dejan de ser considerados un caso periférico del problema. La diversidad no reemplaza la evaluación técnica; obliga a hacerla más exigente.
Esa es la parte que me gustaría conservar. La discusión sobre lenguas suele caer en dos extremos: un universalismo que trata la diversidad como un detalle folclórico y un localismo que la convierte en identidad intocable. Marivate se mueve en un lugar más productivo: la lengua como infraestructura, la comunidad como productora de conocimiento, la tecnología como algo que se negocia.
Vukosi Marivate sirve como precursor porque altera una imagen muy instalada de la inteligencia artificial: un núcleo tecnológico inventa y el resto del mundo adopta. Su trayectoria propone otra circulación. Las comunidades pueden producir datos, modelos, criterios, instituciones y empresas. Pueden decidir qué problemas merecen ser resueltos y cuáles no. Pueden aprender de herramientas construidas afuera sin aceptar que la única dirección posible sea importarlas intactas.
Eso no garantiza soberanía ni justicia. Tampoco elimina dependencias globales de cómputo, capital o infraestructura. Lo que sí cambia es la posición desde la cual se negocian.
Una lengua ausente de un modelo es menos una anomalía estadística que una señal de qué parte del mundo fue considerada suficientemente importante como para ser convertida en datos, herramientas y capacidad técnica. La pregunta ya no es cuántas lenguas puede enumerar una máquina, sino quién participa cuando la máquina aprende a entenderlas.
Lo que sigue abierto es si esa participación puede sostenerse cuando el financiamiento se retira o cuando la lengua deja de estar de moda en un programa internacional. La capacidad construida es frágil, y la diferencia entre un ecosistema y una campaña de capacitación se mide en lo que queda después del próximo ciclo de subsidios.
LENGUA · DATOS · MASAKHANE · NLP · BAJOS RECURSOS · PARTICIPACIÓN · SOBERANÍA · INFRAESTRUCTURA · ECOSISTEMA · ÁFRICA · ADAPTACIÓN · CAPACIDAD ---
Marivate, Vukosi. “Beyond the Symbols: Natural Language Processing as an Adaptive Problem”. Conferencia inaugural y materiales de la University of Pretoria / AfriDSAI, 2025.
University of Pretoria. Perfil académico de Vukosi Marivate.
Nekoto, Wilhelmina; Marivate, Vukosi; et al. “Participatory Research for Low-resourced Machine Translation: A Case Study in African Languages”. Findings of EMNLP, 2020.
Adelani, David Ifeoluwa; Marivate, Vukosi; et al. “MasakhaNER 2.0: Africa-centric Transfer Learning for Named Entity Recognition”. EMNLP, 2022.
University of Pretoria / AfriDSAI. Materiales institucionales sobre AfriDSAI, Deep Learning Indaba 2026 y ecosistemas africanos de IA.
University of Pretoria. “UP’s Prof Vukosi Marivate appointed to UN Independent International Scientific Panel on AI”, 2026.
Publicado
Joan Kinyua
Data Labelers Association of Kenya
Publicado
Milagros Miceli