Imagen: Good Fire
20 OCT 2026
INTELIGENCIA ARTIFICIAL / INTERPRETABILIDAD - Global
La caja negra se volvió gris
Nick Cammarata, investigador de Goodfire y antes en OpenAI, publicó un ensayo según el cual cerca del 90 % de las neuronas de modelos grandes cumplen una única función. En 2023, un trabajo del mismo equipo encontraba apenas entre el 1,7 y el 2 % de neuronas legibles.
Lo que ocurrió
Cerca del 90 % de las neuronas de Qwen3-32B, según un ensayo
Nick Cammarata, investigador de la startup de interpretabilidad Goodfire y antes en OpenAI, publicó el 15 de octubre el ensayo «Neural Networks Are Already Clean». Su tesis: en modelos grandes como Qwen3-32B, cerca del 90 % de las neuronas cumple una única función principal, otro 7 % cubre dos funciones relacionadas y sólo entre el 2 y el 4 % permanece sin explicar, según análisis preliminares con métodos agénticos automatizados. En 2023, un trabajo en el que participó el mismo investigador había encontrado que apenas entre el 1,7 y el 2 % de las neuronas eran legibles con las herramientas de entonces. Cammarata sostiene además que la «superposición» —la idea de que una neurona codifica muchos conceptos a la vez— describía defectos de análisis o de arquitectura más que una propiedad del modelo. La repercusión fue amplia: MIT Technology Review, Chosun Ilbo, Futurism y medios científicos europeos cubrieron el ensayo entre el 16 y el 19 de octubre, con reacciones divididas y pedidos de replicación independiente.
Desde La Intemperie
Identificar una neurona no es comprender el circuito
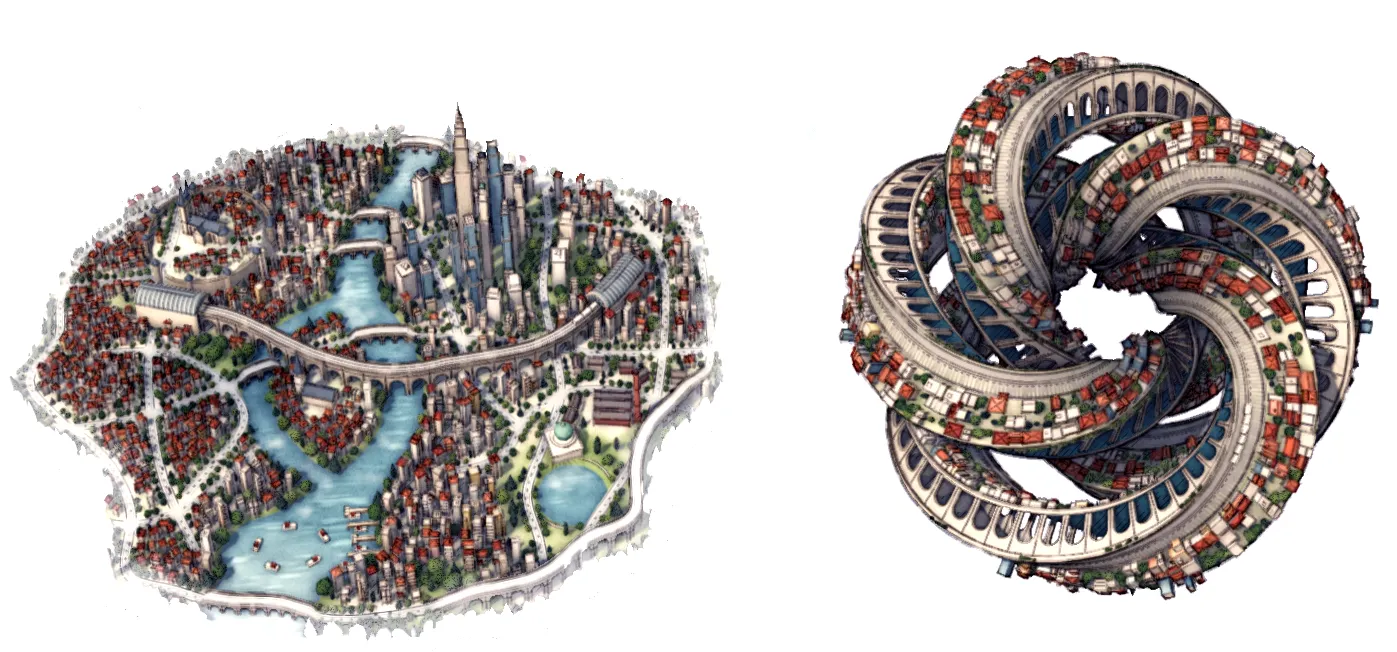
Durante una década, la caja negra funcionó como excusa y como programa. Si no se puede mirar adentro, la regulación se conforma con vigilar lo que sale: sesgos medibles, daños observables, auditorías de comportamiento. La interpretabilidad prometía cambiar esa economía política, pero llevaba años estancada en el 2 %. El ensayo de Cammarata dice que el hiato era del método, no del modelo.
Hay tres cosas distintas que conviene no confundir: que una neurona tenga una función identificable, que se entienda el circuito que la conecta con otras y que eso permita predecir o corregir el comportamiento del sistema. El 90 % pertenece al primer nivel. La cobertura de la semana lo trató como si fuera el tercero.
Y hay un detalle que se repitió poco: el salto se produjo con análisis automatizados por agentes, es decir, con sistemas de IA estudiando sistemas de IA. La interpretabilidad se volvió scalable y, con ella, delegó en una máquina la tarea de explicar a otra máquina.
POR QUÉ NOS IMPORTA
Si la caja se abre, se debilita el argumento más usado para no exigir nada a quien la construye. Pero la apertura también es un acto de autoridad: quien mide decide qué cuenta como legible. La pregunta que queda no es si el modelo es transparente, sino quién audita al que audita.
FUENTES DE CONTRASTE
- Crypto Briefing — «Former OpenAI researcher Nick Cammarata says most AI neurons are now interpretable», 16 de octubre de 2026
- MIT Technology Review — «“We were looking at it wrong”: The explosive claim that’s upended the AI world», 19 de octubre de 2026
- Chosun Ilbo (English) — «AI Black Box Cracked? Silicon Valley Divided», 19 de octubre de 2026
- OfficeChai — «AI Researcher Nick Cammarata Who Helped Discover “Superposition” Now Says the Theory Was Wrong», octubre de 2026
Hechos comprobados: el ensayo «Neural Networks Are Already Clean» fue publicado el 15 de octubre de 2026 por Nick Cammarata, investigador de Goodfire y antes en OpenAI; las cifras de 90 %, 7 % y 2-4 % corresponden a análisis preliminares sobre modelos como Qwen3-32B; la referencia de 1,7-2 % proviene de un trabajo de 2023 en el que participó el mismo investigador; el ensayo cuestiona la interpretación estándar de la superposición; medios de Estados Unidos, Corea del Sur y Europa cubrieron la tesis entre el 16 y el 19 de octubre.
Pendiente / en discusión: no se localizó una réplica independiente que haya reproducido el 90 % en otros modelos; el ensayo es del propio investigador y no un artículo revisado por pares; las reacciones críticas dentro del campo se conocen por la cobertura periodística y no por un documento público relevado; no se consultó a Goodfire ni a OpenAI por respuesta institucional.
Interpretación de La Intemperie: la distinción entre neurona identificable, circuito comprendido y comportamiento corregible, y la lectura sobre la interpretabilidad delegada en agentes, corresponden a la interpretación editorial.
Título original:
Former OpenAI researcher Nick Cammarata says most AI neurons are now interpretable
Fuente:
Good Fire
– Publicado el 16-10-2026